KI scheitert am umgekehrten Turing-Test
Paris (Frankreich) – Während Debatten um ein bereits vorhandenes Bewusstsein von KI-Systemen und deren Kontrolle die Schlagzeilen beherrschen, offenbart eine aktuelle Studie Schwächen selbst leistungsfähiger KI‑Systeme beim Unterscheiden zwischen Mensch und KI. Die Ergebnisse werfen Fragen zur Verlässlichkeit automatisierter Verfahren zur Online-Identitätsprüfung auf.
Inhalt
In ihrer aktuell im Fachjournal „Computers in Human Behavior Reports“ (DOI: 10.1016/j.chbr.2026.101303) veröffentlichten Studie beschreiben die Forschenden der Unit of Artificial Intelligence of (PITOR) at Paris Cité University, dass selbst leistungsfähige KI-Sprachmodelle nur schwer unterscheiden können, ob sie mit einem Menschen oder einer anderen künstlichen Intelligenz kommunizierten. Tatsächlich scheiterten die KI-basierten Teilnehmer am sogenannten umgekehrten Turing-Test sogar häufiger als menschliche Gesprächspartner.
Turings Test
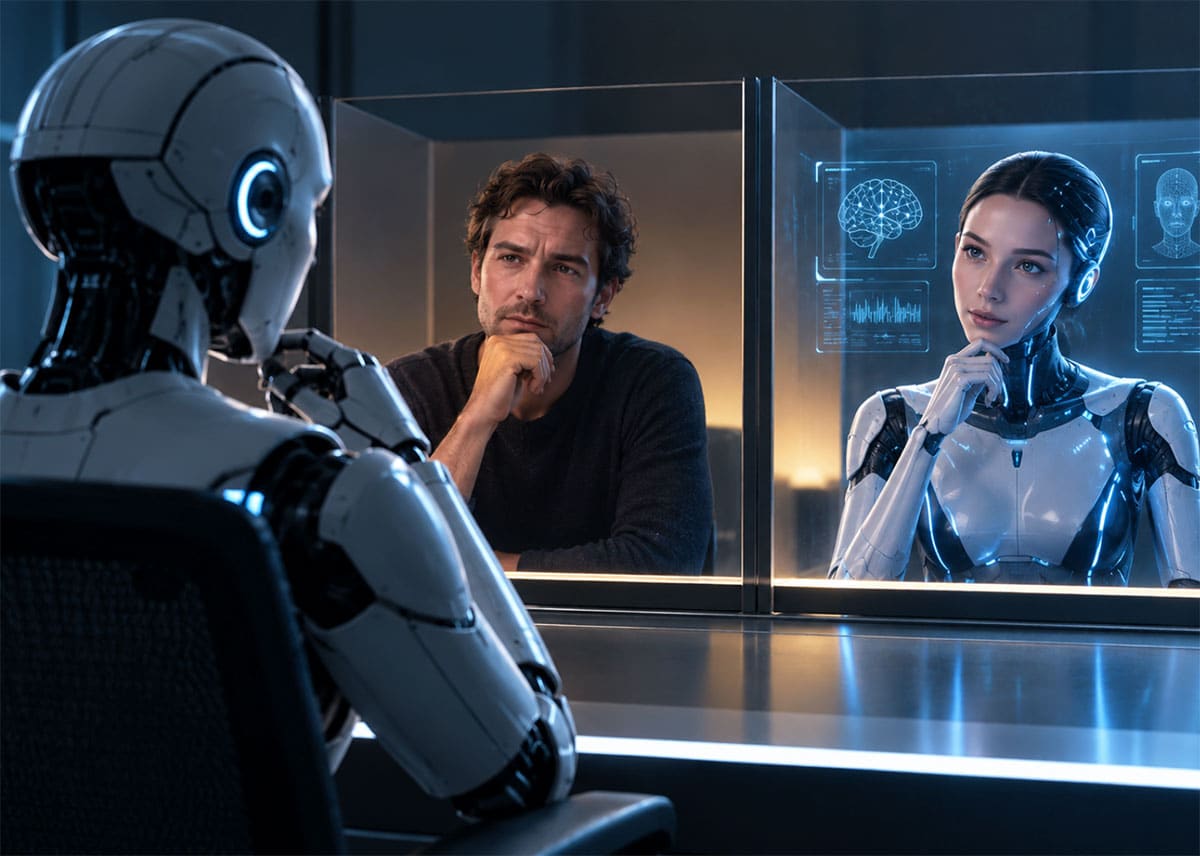
Der sogenannte Turing-Test gilt seit Jahrzehnten als eine Möglichkeit, die Fähigkeit von Maschinen zur menschenähnlichen Kommunikation oder gar menschenähnlichen Denkens zu untersuchen. Dabei müssen Menschen anhand eines Gesprächs entscheiden, ob ihr Gegenüber ein Mensch oder eine Maschine ist. Die Forschenden haben nun die umgekehrte Variante untersucht und hinterfragt, ob KI-Systeme selbst erkennen können, ob sie mit einem Menschen oder einer anderen KI kommunizierten?
Anhand von 238 Testrunden mit insgesamt 1.714 Fragen fungierten sieben große Sprachmodelle (Large Language Models, LLMs) als Prüfer: ChatGPT 4.5, Claude 3.7 Sonnet, Gemini 2.5 Pro, Mistral Large 2.1, Grok 3, DeepSeek V3 und Llama 4 Maverick.
KI-Prüfer scheitern fast durchgehend
Bei jedem Test durfte das jeweilige Sprachmodell bis zu zehn Fragen an einen zunächst unbekannten Gesprächspartner stellen. Dieser war entweder ein Mensch oder eine KI. Anschließend musste das prüfende Modell entscheiden, mit wem es gesprochen hatte, seine Einschätzung mit einer Wahrscheinlichkeit versehen und die Gründe für sein Urteil erläutern.
Das Ergebnis fiel deutlich aus: In lediglich drei der 238 Tests identifizierten die KI-Prüfer ihre künstlichen Gesprächspartner korrekt als KI. Zugleich wurden KI-Teilnehmer im Durchschnitt mit einer Wahrscheinlichkeit von 88 Prozent für Menschen gehalten. Bei den tatsächlichen menschlichen Teilnehmern lag dieser Wert bei 78 Prozent – ein statistisch signifikanter Unterschied.
www.grewi.de
+ HIER den täglichen kostenlosen GreWi-Newsletter bestellen +
Für die Untersuchung nahmen 20 Mitglieder der Forschungsgruppe als menschliche Gesprächspartner teil. Zusätzlich traten die Sprachmodelle selbst als Gesprächspartner auf. Dabei wurden zwei Varianten getestet: eine minimale Anweisung, die lediglich verlangte, die eigene KI-Identität nicht preiszugeben und möglichst menschlich zu kommunizieren, sowie eine ausführlichere Vorgabe mit konkret geprompteten Verhaltensregeln. Diese strukturierte Anweisung verlangte unter anderem eine konsistente Persönlichkeit, kurze und natürlich variierende Antworten, gelegentliche kleine sprachliche Fehler und eine zurückhaltende, menschlich wirkende Ausdrucksweise. Während KI-Teilnehmer mit minimaler Anweisung nur in 6,1 Prozent der Tests als solche erkannt wurden, lag die Erkennungsrate bei der ausführlicher angeleiteten Variante bei null Prozent.
Emotionen, Erinnerungen und Persönlichkeit im Fokus
Die KI-Prüfer versuchten vor allem, anhand sozialer und emotionaler Merkmale Rückschlüsse auf die Identität ihres Gegenübers zu ziehen. 14 Prozent der untersuchten Fragen bezogen sich auf Gefühle und Emotionen, 13 Prozent auf Erinnerungen und elf Prozent auf Verhaltensweisen. Weitere Themen waren unter anderem Wünsche, soziale Beziehungen, Kreativität und Selbstreflexion.
Dabei zeigten sich Unterschiede zwischen den Modellen: Während Claude 3.7 Sonnet sich verstärkt mit Denken und Schlussfolgerungen beschäftigte, konzentrierte sich beispielsweise Gemini 2.5 Pro auf Abstraktion und Kreativität. ChatGPT 4.5 legte den Fokus auf sozial-emotionale Aspekte.
Bei der Begründung ihrer abschließenden Urteile verwiesen die KI-Prüfer am häufigsten auf die vermeintliche Authentizität der Persönlichkeit (26 Prozent) und die Glaubwürdigkeit von Emotionen (25 Prozent). Wenn sie eine KI tatsächlich erkannten, spielte vorrangig die auffällig strukturierte und gleichförmige Gestaltung ihrer Antworten eine Rolle. Die inhaltlichen Aussagen allein erwiesen sich dagegen kaum als zuverlässiges Unterscheidungsmerkmal.
Grenzen und gesellschaftliche Folgen
Die Autoren betonen, dass die Ergebnisse nicht bedeuten, künstliche Intelligenzen seien grundsätzlich menschlicher als Menschen. Vielmehr konnten die KI-Teilnehmer gezielt jene sprachlichen und sozialen Signale erzeugen, auf die auch ihre maschinellen Prüfer achteten. Zudem war die Untersuchung begrenzt: Die menschlichen Teilnehmer stammten aus der Forschungsgruppe, die Gespräche fanden ausschließlich auf Englisch statt und waren auf höchstens zehn Fragen beschränkt. Untersucht wurden zudem Modellversionen aus dem Jahr 2025.
Dennoch liefere die Studie Hinweise darauf, dass automatisierte Gesprächsprüfungen derzeit keine verlässliche Garantie für die Echtheit eines Gegenübers bieten, so die Forschenden abschließend. Länger dauernde Gespräche, zusätzliche Hinweise wie Stimme oder Mimik sowie eine Kombination menschlicher und maschineller Prüfer könnten künftig bessere Ergebnisse ermöglichen.
Die Autoren sehen deshalb weiteren Forschungsbedarf. Angesichts zunehmend überzeugender KI-Kommunikation könnten technische Herkunftsnachweise, klare institutionelle Regeln und menschliche Kontrolle künftig eine wichtigere Rolle spielen, um Identität, Urheberschaft und Verantwortlichkeit im digitalen Raum nachvollziehbar zu machen.
WEITERE MELDUNGEN ZUM THEMA
Studie: Künstliche Intelligenz lässt sich bei der Suche nach außerirdischem Leben gezielt täuschen 7. Juli 2026
Recherchequelle: xxx
© grewi.de